
XDA Developers tarafından “Yerel LLM’ler, kullanılmayan bağlam nedeniyle sessizce RAM tüketiyor; tek bir ayarla bellek geri kazanılabilir” başlığıyla aktarıldığı kadarıyla,
Ollama, yapılandırılmış bağlam penceresinin tamamı için RAM ayırarak pratikte kullanılmayan alanı da bellekte tutar. 32K bağlam penceresiyle yüklenen bir modelde istem ve yanıtlar genellikle yalnızca birkaç bin tokena ulaşsa bile kalan kapasite kullanılmaz. Bu durum doğrudan bellek maliyeti doğurur: Ollama, yapılandırılmış bağlam uzunluğu için KV önbelleği oluşturur ve bu önbellek, indirilen modele ek olarak birkaç GB'a varan bellek tüketebilir. Sorun yalnızca Ollama’ya özgü değildir. llama.cpp ile LM Studio’nun llama.cpp motorunda çalıştırılan GGUF modellerinde de benzer bir bellek kullanımı görülür. Düşük RAM kapasiteli sistemlerde bağlam penceresi, gerçek kullanım düzeyine yakın bir değere düşürüldüğünde diğer işlere daha fazla bellek ayrılabilir.
Ollama, kullanılmayabilecek bağlam için bellek ayırıyor
Bu durum tüm işlemleri yavaşlatır
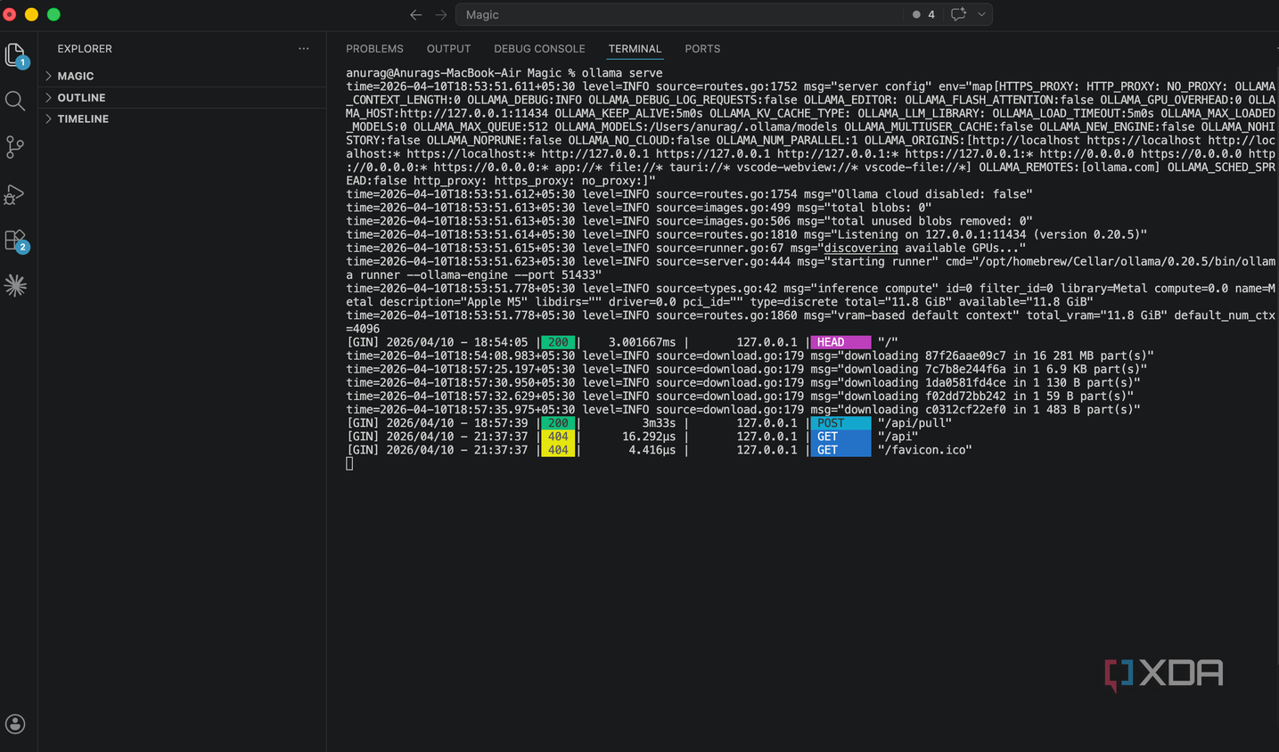
Bağlam uzunluğu, geçerli istemin ne kadarını kullandığını gösteren bir ölçüm değil, modelin destekleyebileceği azami kapasitedir. Bu kapasite; sistem istemini, konuşma geçmişini, geçerli girdiyi ve üretilen yanıtı kapsar. Bir model 32 bin jetonluk bir sınırla yapılandırılabilir ve olağan bir görüşmede yalnızca 3 bin jeton kullanılabilir. Bununla birlikte, Ollama modeli yüklerken onu daha yüksek sınırı karşılayacak şekilde hazırlar.
Ek belleğin büyük bölümü KV önbelleğine ayrılır. Bu önbellek, modelin daha önce işlediği jetonlara ilişkin hesaplamaları saklayarak tüm konuşmanın yeniden işlenmesini önler. Bağlam penceresi büyüdükçe bu hesaplamalar için daha fazla alan gerekir. Ollama ve llama.cpp tabanlı diğer çalışma zamanlarında ayrılan bellek, sonradan gönderilen kısa istemin uzunluğuna değil, yapılandırılmış kapasiteye bağlıdır.
İndirilen model boyutu, bu ek bellek tüketimini açıkça yansıtmaz. Örneğin, 5 GB'lık bir Q4 modeli nicelleştirilmiş ağırlıkların kapladığı alanı gösterir; Ollama'nın hesaplama tamponları ve KV önbelleği için ek alan gerekir. Model ağırlıklarının boyutu azaltılsa bile, aşırı yüksek bir bağlam ayarı bellekte birkaç gigabayt ek tüketim oluşturabilir.
Apple Silicon sistemlerinde bu ayrım, macOS'nin ve diğer uygulamaların kullandığı birleşik bellek havuzundan karşılanır. Ayrı bir GPU bulunan sistemlerde ayrılan bellek normalde VRAM'den karşılanır; VRAM tükendiğinde bu belleğin bir bölümü sistem veya paylaşılan belleğe aktarılabilir. Kullanılmayan bağlam kapasitesi, olağan isteklere katkı sağlamadan diğer uygulamaların kullanabileceği belleği azaltır veya modelin bir bölümünü daha yavaş belleğe taşır. Ollama'nın mevcut varsayılanları, VRAM kapasitesi daha yüksek sistemlerde bu durumu ağırlaştırabilir. Mevcut yaklaşıma göre 24 GiB'nin altındaki sistemlerde 4K, 24–48 GiB aralığında 32K, 48 GiB ve üzerindeki sistemlerde ise 256K bağlam sınırı atanır.
Kullanımın gerçek gereksinimlerine göre bağlam sınırı belirlenmelidir
Her kullanım için daha yüksek bir bağlam sınırı gerekmez
Ollama API’si, bağlam penceresi seçiminde değerlendirilebilecek ölçütler sunar. Yanıtlar; girdi belirteçlerini bildiren prompt_eval_count ile üretilen belirteçleri gösteren eval_count alanlarını içerir. Bu değerler, farklı konuşmalar karşılaştırılarak modelin ilan edilen en yüksek sınırından daha uygun bir başlangıç noktası belirlenmesini sağlar. Karşılaştırmaya daha uzun konuşmaların dahil edilmesi, kapasite planlamasının tek bir kısa soruya göre yapılmasını önler.
Binlerce belirteçe ulaşan konuşmalar için ilk deneme 8K bağlam penceresiyle yapılabilir. Bu ayar, izleme sorularına ve olağan dışı uzun yanıtlara yer bırakırken 32K’ye doğrudan geçmeyi gereksiz kılar. Akıl yürütme modelleri ayrıca değerlendirilmelidir; bu modeller, nihai yanıttan önce akıl yürütme belirteçleri üretir. Ollama bu süreci ayrı gösterdiğinden, sohbet arayüzünde görünen yanıt üretimin tamamını yansıtmayabilir. İlgili çıktı da kapasite planlamasına dahil edilmelidir.
Ollama uygulamasındaki bağlam penceresi ayarı değiştirilebilir veya terminal oturumunda /set parameter num_ctx 8192 komutu girilebilir. Modele özel kalıcı ayar için Modelfile dosyasında PARAMETER num_ctx 8192 tanımı kullanılabilir. Daha küçük pencere; önceki mesajlardan bilgiye ihtiyaç duyan bir konuşmayla test edilmelidir. Kırpma etkinleştirildiğinde Ollama, belirlenen sınırı karşılamak için eski mesajları çıkarır; sistem mesajları ile en yeni mesaj korunur.
Önbellek hassasiyeti ve eşzamanlı istekler de dikkat gerektirir
Bellek kullanımını azaltmaya da yardımcı olabilirler
Ollama, bellek kullanımını azaltmaya yönelik başka bir seçenek olarak konuşma önbelleğini daha düşük sayısal hassasiyetle saklamayı sunar. Bu yöntem önbellek kuantizasyonu olarak adlandırılır. Varsayılan önbelleğin yaklaşık yarısı kadar bellek kullanan 8 bitlik seçenek, genellikle Q8 etiketiyle gösterilir. Konuşma sınırı değişmez; ancak önbellekte saklanan sayıların hassasiyeti azalır. Elde edilen tasruf yalnızca önbellekle sınırlıdır ve modelin toplam bellek gereksinimini yarıya indirmez.
Q8 seçeneği, yanıt kalitesi üzerindeki etkisi genellikle sınırlı olduğu için öncelikli olarak test edilebilir. Önbelleği yaklaşık çeyrek boyutuna indirebilen Q4 seçeneği ise daha fazla bellek tasarrufu sağlar. Bununla birlikte, daha yüksek hassasiyet kaybı özellikle uzun konuşmalarda yanıtların doğruluğunu etkileyebilir. Her iki ayarın kalıcı olarak etkinleştirilmeden önce birkaç tanıdık sorunun yanıtları karşılaştırmalı olarak değerlendirilmelidir.
Ollama’nın aynı anda kaç isteği işleyeceği de denetlenmelidir. Birden fazla konuşmanın eşzamanlı olarak yanıt üretmesine izin verilmesi, daha fazla önbellek kapasitesinin kullanılmasına yol açabilir. Birden fazla kullanıcının veya uygulamanın yerel sunucuyu paylaşması durumunda eşzamanlı kapasite yararlı olabilir. Tek seferde tek isteğin işlenip yanıtın beklenmesi yeterliyse ek kapasite ayırmaya gerek yoktur. Ollama’nın varsayılanı aynı anda bir isteği işlemektir; bu ayar yalnızca daha önce artırıldıysa yeniden değerlendirilmelidir.
Diğer çıkarım seçenekleri de değerlendirilebilir
Ollama, modellerin yerel ortamda çalıştırılmasında güçlü bir seçenek olmakla birlikte farklı çözümler de karşılaştırılabilir. LM Studio, Docker Model Runner ve BaseRT; kurulum, yönetim ve performans gereksinimleri açısından test edilerek Ollama’ya alternatif olarak değerlendirilebilir.